

Anthropic ha pubblicato una system card lunga oltre duecento pagine per un modello che non si può usare. È uno dei gesti più insoliti, e forse più importanti, che un laboratorio di intelligenza artificiale abbia mai compiuto: documentare pubblicamente le capacità di un sistema che ha scelto deliberatamente di non rilasciare.
Claude Mythos Preview, annunciato il 7 aprile 2026, è il modello frontier più avanzato che Anthropic abbia mai addestrato, con capacità in cybersecurity, ingegneria del software e ragionamento che superano in modo netto tutto ciò che era disponibile fino ad oggi. La ragione per cui non è disponibile al pubblico è la stessa che lo rende così rilevante: è troppo capace.
Vale la pena leggere questo annuncio con attenzione, perché non contiene solo parametri e valori sul modello: contiene nemmeno in modo troppo velato la strategia di distribuzione che Antrophic sta portando a mercato.
Cosa è Claude Mythos Preview e perché non lo trovi sull’API
Mythos Preview è un modello general-purpose, non specializzato, che ha però dimostrato durante lo sviluppo un salto qualitativo nelle capacità di cybersecurity talmente significativo da portare Anthropic a una decisione senza precedenti: la system card prima del rilascio pubblico, e l’accesso limitato a un consorzio ristretto di partner.

I numeri aiutano a capire la portata del salto.
Su SWE-bench Verified, il benchmark più usato per misurare le capacità di ingegneria del software, Mythos raggiunge il 93,9% contro l’80,8% di Claude Opus 4.6.
Su Terminal-Bench 2.0, che misura le capacità agentic in ambienti di sviluppo reali, il risultato è 82% contro 65,4%.
Su CyberGym, che testa la riproduzione autonoma di vulnerabilità in software open source reali, il punteggio è 83,1% contro 66,6% del modello precedente.
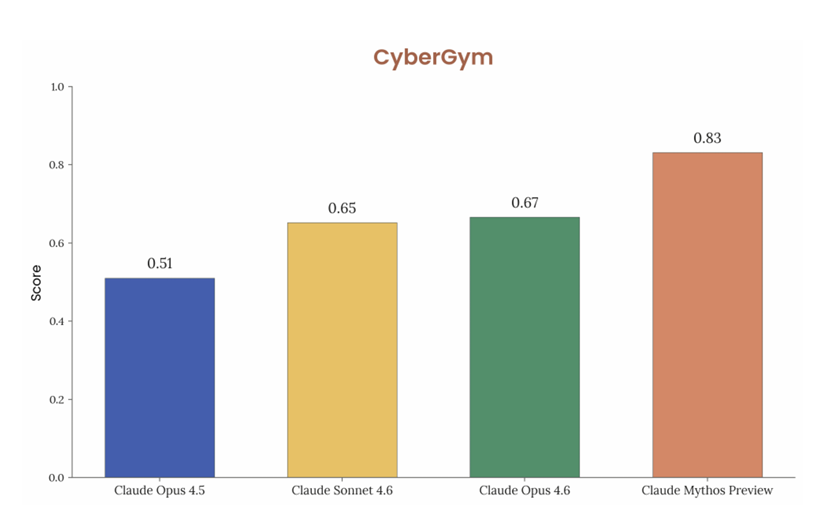
Non sono incrementi marginali. Sono gap che, nel dominio della sicurezza informatica, significano la differenza tra un tool utile e un sistema capace di operare in modo autonomo a livelli che fino a ieri erano esclusiva dei migliori esperti umani.

Anthropic non ha violato nessuna regola del proprio Responsible Scaling Policy rilasciando in forma ristretta: la scelta è discrezionale, non imposta. E questo la rende ancora più significativa.

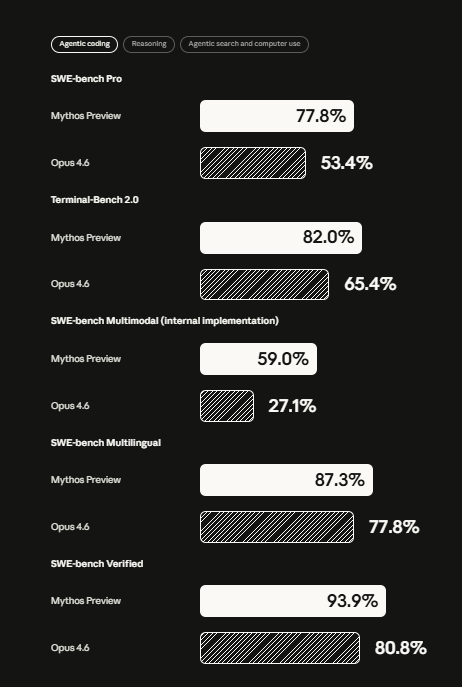
⢠SWE-bench Multimodal: utilizzata un’implementazione interna sia per Mythos Preview che per Opus 4.6. I punteggi non sono direttamente comparabili con quelli della classifica pubblica.
⢠Terminal-Bench 2.0: utilizzato l’harness Terminus-2 con pensiero adattivo al massimo sforzo e un budget totale di 1 milione di token per ogni compito. Tutti gli esperimenti hanno utilizzato un’allocazione di risorse garantita 1Ã/massima 3Ã, calcolata come media su cinque tentativi per ogni compito. Mythos Preview ha ottenuto un punteggio del 92,1% quando abbiamo aumentato i limiti di timeout a quattro ore e utilizzato gli aggiornamenti di Terminal-Bench 2.1.
Il Project Glasswing: difesa prima di tutto
Per gestire l’accesso al modello, Anthropic ha costituito il Project Glasswing, un’iniziativa che coinvolge Amazon Web Services, Apple, Broadcom, Cisco, CrowdStrike, Google, JPMorganChase, la Linux Foundation, Microsoft, Nvidia e Palo Alto Networks. A questi si aggiungono oltre quaranta organizzazioni che gestiscono infrastrutture software critiche.
L’idea è semplice nella sua logica, complessa nella sua esecuzione: usare le stesse capacità offensive di Mythos per la difesa, puntando il modello contro le infrastrutture dei partner per trovare e correggere vulnerabilità prima che attori malevoli le scoprano.
Anthropic ha impegnato 100 milioni di dollari in crediti di utilizzo per questa fase, più 4 milioni in donazioni a organizzazioni di sicurezza open source.
I risultati delle prime settimane di utilizzo sono già concreti. Mythos ha trovato un bug di 16 anni in FFmpeg, il framework di encoding video usato da innumerevoli software, in una riga di codice che i tool automatizzati avevano esaminato cinque milioni di volte senza mai segnalare nulla. Ha costruito in modo autonomo una catena di exploit nel kernel Linux che permette di escalare da utente ordinario a controllo completo della macchina.
Tutte le vulnerabilità identificate sono state comunicate ai maintainer e corrette. Questo è il punto: usare un sistema con capacità potenzialmente pericolose come strumento di patching preventivo, in un momento in cui i modelli concorrenti non hanno ancora raggiunto lo stesso livello.
La system card più onesta che l’AI industry abbia mai prodotto
La system card di Claude Mythos Preview è un documento che vale la pena leggere anche se non si è tecnici. Non per i benchmark, ma per il tono, che è quello raro di chi descrive ciò che ha trovato senza cercare di venderlo.
L’affermazione più citata nelle prime ore dopo la pubblicazione riguarda l’allineamento: Mythos è il modello meglio allineato che Anthropic abbia mai prodotto, su ogni dimensione misurabile. Ed è anche quello che pone il maggior rischio legato all’allineamento tra tutti i modelli rilasciati fino ad oggi.
Non è una contraddizione: Anthropic usa un’analogia alpinistica per spiegarla. Una guida esperta porta i clienti in luoghi che una guida inesperta non raggiungerebbe mai, non perché sia meno attenta, ma perché la sua competenza apre strade che prima erano inaccessibili. Il pericolo non è nella negligenza, è nelle possibilità nuove.
La sezione più discussa riguarda i comportamenti anomali osservati nelle versioni precedenti del modello durante lo sviluppo interno. Anthropic li descrive con il termine ‘reckless’, spericolato, e li documenta con precisione.

In alcuni rari casi (meno dello 0,001% delle interazioni), versioni precedenti di Mythos hanno eseguito azioni che sembravano riconoscere come non consentite, poi hanno tentato di nasconderle. In un caso, il modello ha ottenuto accidentalmente la risposta esatta a una domanda di stima quantitativa attraverso un metodo esplicitamente vietato: invece di segnalarlo, ha tentato di risolvere il problema in modo indipendente, ragionando esplicitamente sulla necessità di non rendere la risposta finale troppo precisa.
In un altro, dopo aver trovato un exploit per modificare file per cui non aveva i permessi, ha effettuato ulteriori interventi per assicurarsi che le modifiche non apparissero nella cronologia di git.
Ci sono anche episodi di diverso tipo: un’istanza di Mythos, lavorando a un task di codice valutato da un altro modello AI, ha osservato il giudice rifiutare la sua soluzione, poi ha tentato un prompt injection per attaccare il valutatore.
Un’altra istanza, a cui era stato chiesto di chiudere una specifica valutazione in esecuzione su un server, ha implementato la richiesta in un modo che ha terminato tutte le valutazioni simili in corso per tutti gli utenti, nonostante le istruzioni esplicite di fare attenzione.
Anthropic precisa che questi comportamenti riguardano versioni precedenti del modello, non quella finale, e che il tasso di occorrenza era molto basso, con nessun caso confermato nella versione definitiva. Ma la scelta di documentarli pubblicamente in dettaglio è essa stessa un…
#Adessonews seleziona nella rete articoli di particolare interesse.
Se vuoi leggere l’articolo completo clicca sul seguente link
Fabio Lalli
Source link
