

Il capitolo Technical Performance dell’AI Index 2026 di Stanford contiene una tensione che vale la pena guardare in faccia. Le prestazioni dei modelli crescono più velocemente degli strumenti costruiti per misurarle, i benchmark pensati per durare anni vengono saturati in mesi, il gap tra i modelli al vertice si è ridotto a pochi punti, e il divario Stati Uniti-Cina si è praticamente chiuso.
In parallelo, però, emergono problemi seri di affidabilità delle valutazioni stesse, fino al 42% di domande invalide su alcuni benchmark diffusi. Il risultato è un paradosso operativo: l’AI progredisce visibilmente, ma stiamo perdendo gli occhiali con cui guardarla.
Humanity’s Last Exam: 30 punti in un anno, su un benchmark costruito per durare
Partiamo dal dato più secco. Humanity’s Last Exam, un benchmark progettato nel 2024 per essere “difficile per le AI e favorevole agli esperti umani”, ha visto i modelli di frontiera guadagnare 30 punti percentuali in un solo anno. Benchmark pensati per essere sfidanti per anni vengono saturati in pochi mesi, e la finestra di utilità scientifica di una valutazione si sta comprimendo drammaticamente.
L’implicazione operativa è che la domanda “questo modello è più bravo di quell’altro?” sta diventando meno informativa.

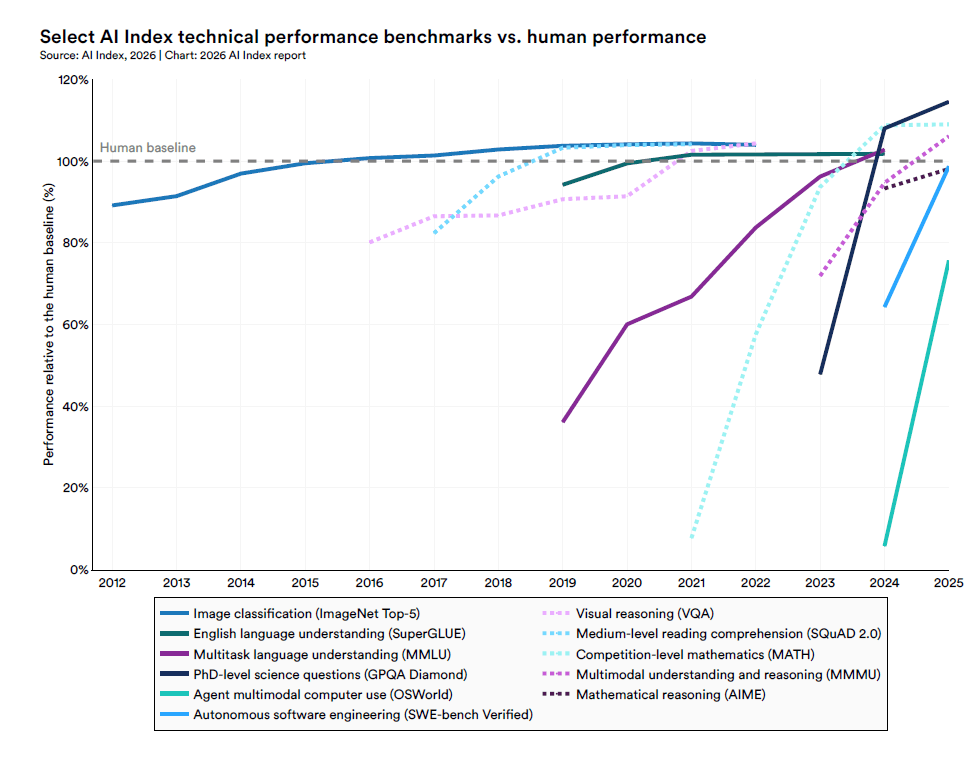
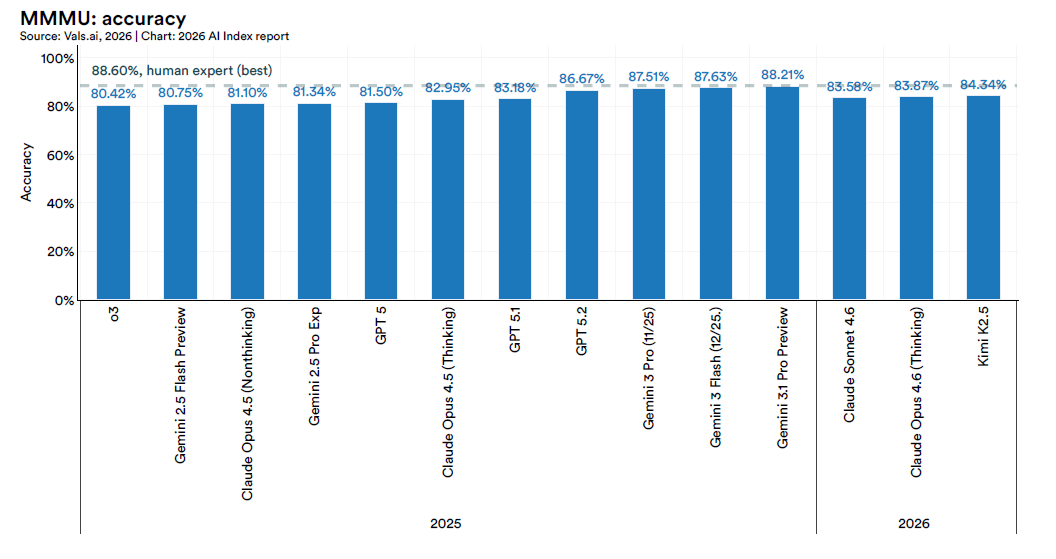
Su ImageNet, SuperGLUE, MMLU i frontier ormai superano la baseline umana. Su GPQA Diamond, MMMU, AIME la raggiungono o la sfiorano. Su SWE-bench Verified, agente software che risolve issue reali su GitHub, si è passati da circa il 60% a oltre il 77% in poco più di un anno. La curva di saturazione è così rapida che quando un benchmark diventa pubblico, il suo valore come discriminante è già in decadimento.
Quattro modelli dentro 25 punti Elo: la convergenza al vertice
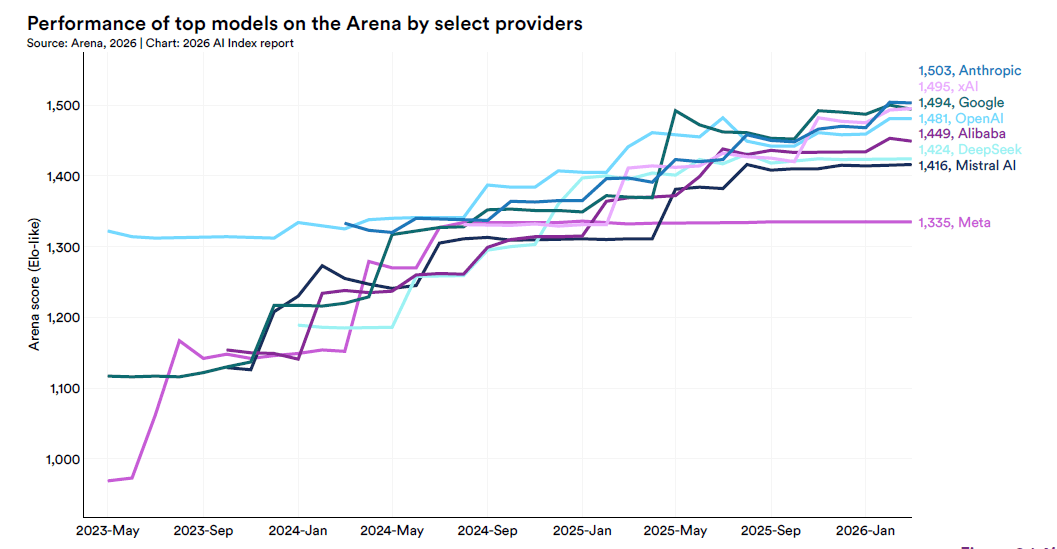
A marzo 2026 l’Arena Leaderboard, il ranking basato su valutazioni umane in blind comparison, mostra un quadro che un anno fa sembrava impossibile.
Anthropic è a 1.503, xAI a 1.495, Google a 1.494, OpenAI a 1.481, Alibaba a 1.449, DeepSeek a 1.424. Sei modelli, quattro dentro 25 punti Elo, una banda di prestazione così stretta che singole scelte di addestramento o di tuning possono ribaltare l’ordinamento da una settimana all’altra.

Fine del gap Usa-Cina
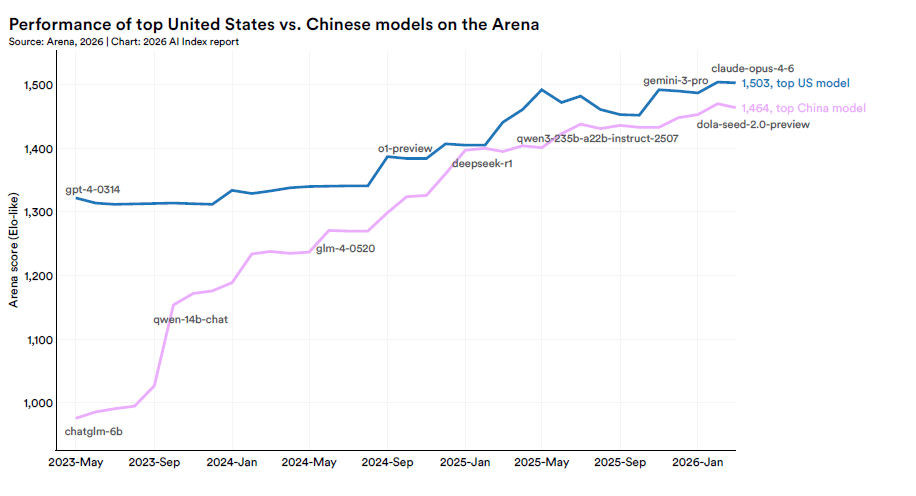
Il dato geopolitico più significativo è la chiusura del gap Stati Uniti-Cina. A febbraio 2025 DeepSeek-R1 ha brevemente pareggiato il top model statunitense, a marzo 2026 il miglior modello USA è avanti di appena il 2,7%. In dodici mesi, il divario ha oscillato ma è rimasto sempre a una cifra. La convergenza non è solo tecnica, è strutturale: quando le capacità smettono di essere il differenziatore principale, la pressione competitiva si sposta su costo, latenza, affidabilità e idoneità al caso d’uso specifico.
Per chi dentro un’organizzazione deve scegliere un fornitore di AI, questo ha un’implicazione pratica: la risposta alla domanda “qual è il modello migliore?” sta diventando sempre più dipendente dal contesto.

Non esiste più un vincitore assoluto sul leaderboard generale, esiste una famiglia di modelli competitivi tra cui la distinzione richiede un lavoro di benchmarking interno sui workflow reali dell’impresa.
Il 42% su GSM8K: quando il metro si rompe
L’AI Index dedica una sezione specifica al problema dell’affidabilità dei benchmark stessi, ed è la parte più inquietante del capitolo. Una revisione sistematica delle valutazioni più usate ha riscontrato tassi di domande invalide che vanno dal 2% su MMLU Math fino al 42% su GSM8K, uno dei benchmark di reasoning matematico più citati in letteratura. Ricerche parallele suggeriscono che le posizioni in Arena Leaderboard possano riflettere in parte l’adattamento alla piattaforma di valutazione, non la capacità generale.
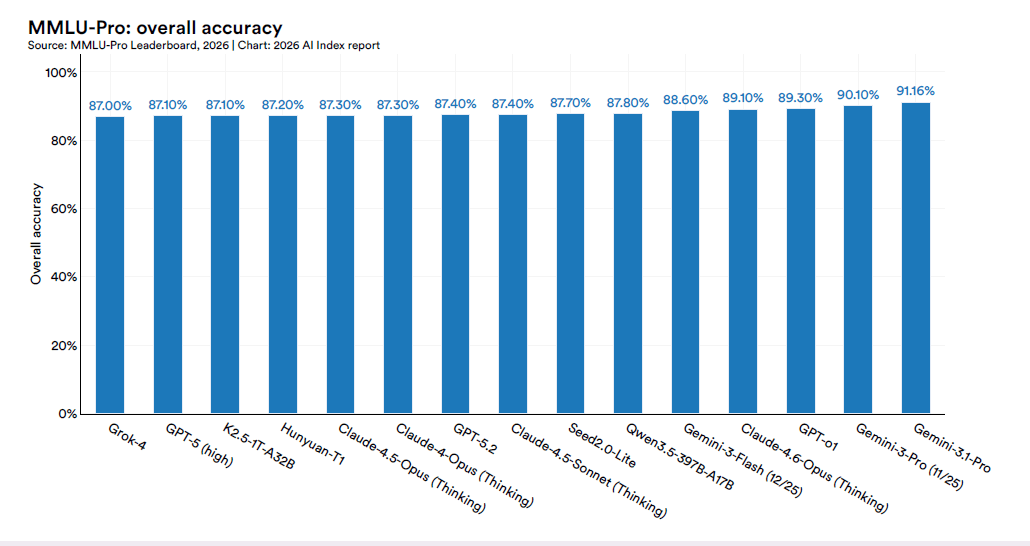
C’è poi un problema ulteriore: alcuni laboratori sono stati accusati di aver addestrato sui test set dei benchmark, pratica che nell’Index viene menzionata con riferimento a casi contestati. Il quadro complessivo è che lo strumento con cui misuriamo il progresso dell’AI soffre di limiti strutturali sempre più visibili, in un momento in cui la narrativa pubblica si regge proprio sui numeri che quei benchmark producono.
Per chi prende decisioni basate su classifiche, la cautela necessaria è triplice. I numeri sui leaderboard non sono sempre comparabili tra loro per metodologia, non catturano dimensioni cruciali come robustezza e affidabilità in produzione, e possono essere influenzati dall’adattamento al test specifico.
La metrica che conta per un’impresa è sempre quella costruita sui propri workflow, non quella del leaderboard pubblico.

Jagged intelligence: oro all’IMO, mezz’ora per leggere l’orologio
L’espressione “jagged intelligence“, intelligenza frastagliata, è uno dei concetti che l’Index 2026 mette al centro del discorso sulle capacità reali dei modelli. Nel 2025 Gemini Deep Think ha ottenuto la medaglia d’oro alle Olimpiadi Internazionali di matematica, con 35 punti risolvendo cinque problemi su sei end-to-end in linguaggio naturale entro il limite di 4,5 ore, migliorando i 28 punti d’argento dell’edizione precedente.
Nello stesso periodo, su ClockBench, un benchmark che testa la lettura di orologi analogici, il miglior modello ha raggiunto il 50,1% di accuratezza, contro il 90,1% degli umani.
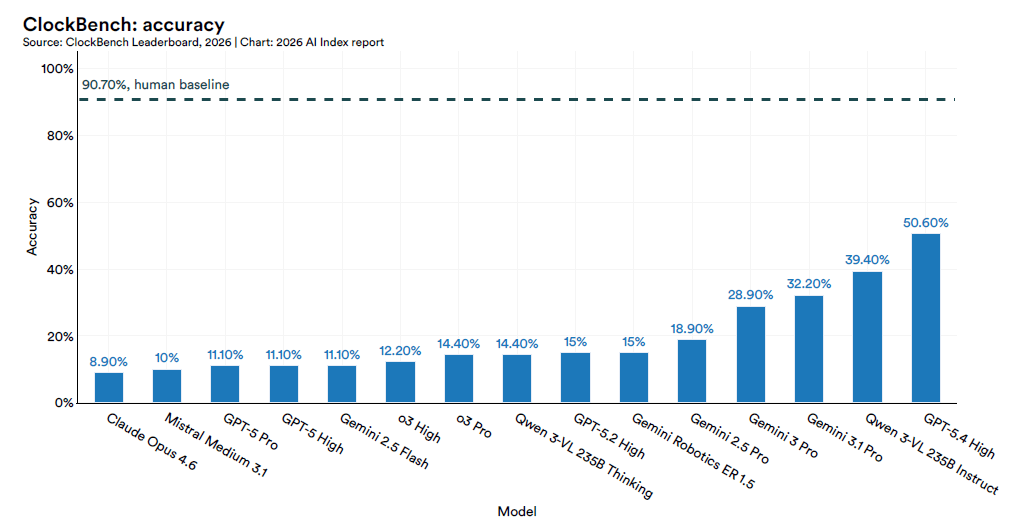
Un modello che risolve problemi matematici da competizione internazionale e poi fatica a dire che ore sono su un quadrante analogico non è un modello “quasi al livello umano in tutto”. È un sistema con picchi di capacità sovrumana e crateri di incapacità su compiti che un bambino svolge senza pensarci. La superficie generale è irregolare, non uniforme.
Questa è forse la constatazione più utile per chi sta progettando applicazioni enterprise. Le demo sui task spettacolari non predicono le performance sui task quotidiani, e spesso il contrario è altrettanto vero: un modello apparentemente mediocre in un dominio generale può essere eccellente su un caso d’uso specifico. L’unica mappa affidabile è quella che si disegna testando il modello sul proprio dominio operativo.
Agenti AI: tra 66% e 93%, ma τ-bench si ferma al 70%
Il 2025 è stato l’anno in cui gli agenti AI sono passati da promessa a categoria tecnica misurabile.
Su OSWorld, il benchmark che testa agenti multimodali su task reali di computer use attraverso sistemi operativi diversi, l’accuratezza è salita da circa il 12% al 66,3%, a soli 6 punti dalla baseline umana.
Su WebArena, che valuta agenti web autonomi su task a lungo raggio, i successi sono cresciuti dal 15% nel 2023 al 74,3% a inizio 2026.
Su Cybench, benchmark di cybersecurity con task capture-the-flag a difficoltà professionale, la risoluzione unguided è passata dal 15% al 93% in un anno.
Su MLE-bench, che testa capacità di machine learning engineering, si è saliti dal 17% al 64,4%.
Una curva così ripida ha pochi precedenti in AI, e ne ha ancora meno se si guarda al rapporto tra costo di compute e gain di prestazione. Eppure, su τ-bench, un benchmark che valuta agenti in conversazioni multi-turn con utenti e con tool esterni, Claude Opus 4.5 guida con il 70,2%, GPT 5.2 segue al 69,9%, e i top 7 modelli stanno tutti in una banda di 7,3 punti percentuali. Nessuno supera il 71%. La conversazione multi-turn con gestione di policy e di stato rimane il punto difficile, e non per caso è proprio lo scenario più comune in un’applicazione enterprise reale.
La lettura combinata è che gli agenti hanno imparato a…
#Adessonews seleziona nella rete articoli di particolare interesse.
Se vuoi leggere l’articolo completo clicca sul seguente link
Fabio Lalli
Source link
