
OpenAI amplia la famiglia GPT-6 con Sol e Luna, due modelli che portano parte delle capacità introdotte con GPT-6 Astra verso fasce di prezzo più basse. I nuovi sistemi sono stati annunciati il 22 settembre 2026 e puntano soprattutto sul rapporto tra capacità, velocità e costo: un elemento che diventa sempre più importante quando i modelli vengono impiegati per agenti software, programmazione e processi aziendali che consumano grandi quantità di token.
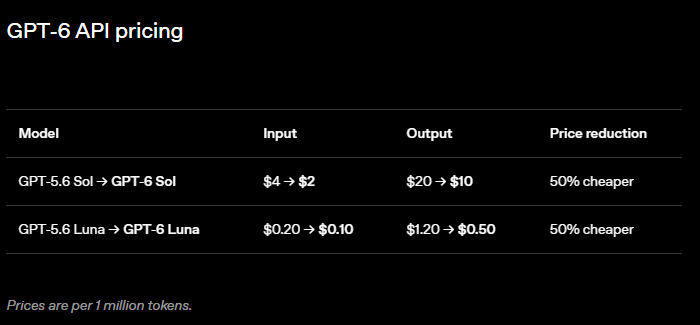
La novità più immediata riguarda i prezzi. Per GPT-6 Sol OpenAI indica 2 dollari per milione di token in input e 10 dollari per milione in output nella tariffazione standard indicata al lancio. GPT-6 Luna scende rispettivamente a 0,10 e 0,50 dollari. OpenAI presenta questi valori come una riduzione del 50% rispetto ai prezzi promozionali dei corrispondenti modelli GPT-5.6.
Il changelog dell’API pubblicato il 22 settembre conferma prezzi e disponibilità dei due nuovi modelli.
Sol e Luna occupano due fasce diverse
La struttura della nuova famiglia chiarisce la strategia di OpenAI.

GPT-6 Astra rimane il modello destinato ai compiti più difficili, con maggiore capacità di ragionamento e un costo più alto.
GPT-6 Sol occupa la fascia intermedia: la documentazione ufficiale lo descrive come un modello pensato per bilanciare capacità e costo, in particolare per coding e workflow agentici complessi.
Luna punta invece sui carichi ad alto volume e sulle attività più circoscritte, dove il costo per richiesta pesa più della capacità massima disponibile.
Tutti e tre i modelli accettano testo e immagini e dispongono, secondo il catalogo OpenAI, di una finestra di contesto fino a 1,05 milioni di token e di un output massimo di 128 mila token. Sol e Luna possono inoltre lavorare con differenti livelli di reasoning effort, dal funzionamento senza ragionamento esteso fino alle modalità più impegnative.
L’obiettivo dichiarato non è quindi sostituire Astra, ma rendere economicamente sostenibili applicazioni nelle quali utilizzare sempre il modello di punta sarebbe troppo costoso. Il punto riguarda soprattutto gli agenti: un singolo compito può richiedere molte chiamate al modello, consultazione di strumenti, analisi di file e iterazioni successive. In questi casi il costo di ogni passaggio si accumula rapidamente.

Il motivo della scelta di nomi di origine latina
I nomi sono effettivamente di origine latina: sol significa “sole”, luna significa “luna”, mentre terra significa “terra”. Sono quindi parole latine entrate quasi senza modifiche anche nell’italiano. Con GPT-6 OpenAI ha mantenuto Sol e Luna e ha chiamato il modello di punta Astra, altra parola latina, plurale di astrum, cioè “astri” o “stelle”. La società parla esplicitamente della “famiglia” GPT-6 composta da Astra, Sol e Luna.
La lettura più plausibile — ma qui siamo nel campo dell’interpretazione, non di una spiegazione ufficiale — è che OpenAI abbia scelto un lessico astronomico latino per rendere più riconoscibile la gerarchia della famiglia rispetto alle vecchie etichette puramente tecniche come “mini” o “nano”. I tre nomi costruiscono inoltre un sistema facile da ricordare e utilizzabile in molte lingue.
OpenAI, almeno nelle fonti ufficiali pubblicate finora, non attribuisce a Sol, Luna o Astra un significato gerarchico simbolico preciso del tipo “il Sole è più potente della Luna”. La gerarchia viene invece dichiarata nelle descrizioni dei prodotti: Astra è il modello di punta, Sol punta al bilanciamento tra capacità e costo, Luna all’efficienza per attività focalizzate e ad alto volume.
I benchmark sul lavoro professionale
OpenAI accompagna il lancio con una serie di test sulle attività professionali. I dati sono prodotti o selezionati dall’azienda e vanno quindi letti per ciò che misurano: confronti eseguiti con specifiche configurazioni, livelli di reasoning effort e costi per task.
Su AutomationBench 1.0.6, benchmark che valuta workflow end-to-end attraverso 47 strumenti impiegati in vendite, marketing, operations, assistenza, finanza e risorse umane, GPT-6 Sol in modalità xhigh raggiunge secondo OpenAI un punteggio del 33,2%.


Claude Opus 5, nella configurazione max usata nel confronto, arriva al 26,9%. La differenza economica indicata è più marcata: un task con Sol costa 0,27 dollari, mentre il costo attribuito a Opus 5 è 11,1 volte superiore.
Nello stesso test GPT-6 Astra in modalità low raggiunge il 30,3%, con un costo per attività che OpenAI quantifica in 3,9 volte quello di Sol.
Claude Fable 5.1 con fallback su Opus 5 arriva invece al 31,4%; nel materiale OpenAI precisa che il costo riportato per questa configurazione non comprende quello dei fallback, avvenuti su circa il 40% delle attività.
Un secondo test, Agents’ Last Exam V1, riguarda attività professionali di lunga durata distribuite su 55 sotto-settori.

OpenAI attribuisce a GPT-6 Sol in configurazione max un risultato del 56,4% e sostiene che il modello raggiunga questo livello con un costo per task inferiore del 60% rispetto alla migliore configurazione di Claude Opus 5 esaminata nel confronto.
Coding: il costo diventa parte della prestazione
Il rapporto tra prezzo e capacità assume un peso particolare nello sviluppo software. Gli agenti di coding possono lavorare per molte iterazioni consecutive, leggere repository, modificare file, eseguire test e correggere gli errori prodotti nelle fasi precedenti.
Nel materiale di lancio OpenAI cita il proprio uso interno come esempio della crescita di questi carichi. Valutando i token ai prezzi dell’API, l’azienda afferma che l’utilizzo quotidiano ha superato l’equivalente di 600 dollari per il ricercatore mediano e di 7.000 dollari per i ricercatori collocati al novantesimo percentile. La cifra non descrive una normale spesa individuale: serve a mostrare quanto possa diventare elevato il consumo quando gli agenti vengono utilizzati in modo intensivo.
Su FrontierCode 1.1 Main, benchmark che valuta anche la “mergeability” del codice prodotto — quindi non soltanto la correttezza, ma aspetti come qualità dei test, disciplina dello scope, stile e rispetto delle convenzioni del repository — OpenAI segnala un miglioramento di Sol rispetto a GPT-5.6 Sol e prestazioni comparabili a Claude Fable 5.1 xhigh a un costo inferiore.

Il confronto prosegue con DeepSWE 1.1, dedicato a problemi di software…
#Adessonews seleziona nella rete articoli di particolare interesse.
Se vuoi leggere l’articolo completo clicca sul seguente link
Pierluigi Sandonnini
Source link
